 AIVideoFree
GPT Image 2 AI-bildgenerator
OpenAIs flaggskepp för bilder: det tänker innan det ritar — planerar layouten och kontrollerar innehållet — och renderar text som du skulle kunna skicka till en skrivare. Skriv en prompt nedan och prova det.
Utvecklare
OpenAI
Skickas som
ChatGPT-bilder 2.0 / gpt-image-2
Signatur
Inbyggt tänkeläge
Text i bild
Utskriftsklart · flerspråkigt
Batchar
8 bilder, konsekventa
Max utdata
2K
Nivå här
Betalda krediter
Efterträdare
Vårt omdöme i en rad: valet för layout. När bilden egentligen är ett dokument — en meny, en affisch, en UI-mockup, vad som helst där ord och struktur måste tåla granskning — planerar den här modellen det innan den ritar det.
GPT Image 2 kom i april och tog förstaplatsen i varje Image Arena-kategori inom tolv timmar — med 242 poäng, den största marginalen som topplistan någonsin hade registrerat. Den arkitektoniska orsaken är den intressanta delen: det är OpenAI:s första bildmodell med inbyggd resonemangsförmåga, som planerar layouten och kontrollerar innehållet före rendering, vilket är anledningen till att dess paradnummer är det historiskt omöjliga — en restaurangmeny där varje rätt är rättstavad och varje pris är korrekt justerat. Två aktuella noteringar: OpenAI pensionerade gamla DALL·E den 30 augusti och det här är modellen som ersatte den — och från och med den 8 september har den en egen efterföljare, GPT Image 2.5 , vilket behåller den här arkitekturen och ungefär halverar väntetiden. Den här sidan finns kvar eftersom arenaregistret, batcherna med 8 bilder och resonemangsbeteendet som dokumenteras här fortfarande är exakt vad du får; den nyare sidan tar upp vad som har ändrats.
Där GPT Image 2 vinner — och där den inte gör det
Bedömt utifrån våra egna renderingar och det publicerade underlaget, reviderat i takt med att fakta ändras — det är en funktion på den här sidan, inte en ansvarsfriskrivning.
Verkligen stark
• Tänker innan ritning.
Inbyggd resonering planerar kompositionen och verifierar innehållet före rendering — komplexa layouter, scener med flera element och instruktionsstackar lyckas mycket oftare på första försöket.
• Utskriftsklar text.
Menyer, affischer, förpackningar, UI-mockups — flerspråkiga, korrekt stavade, korrekt formaterade. Felläget som definierade AI-bilder i åratal, behandlat som ett löst område.
• Konsekventa batcher med 8 bilder.
En begäran, åtta varianter som behåller karaktär och stil — iterations- och A/B-arbetsflödet är inbyggt i modellen, inte påbultat i efterhand.
• Dokumentbildsbanan.
Allt som i hemlighet är ett dokument — certifikat, etiketter, presentationsbilder, annonsmockuper — är där resonemangslagret tydligt överträffar rivaler som bygger på mönstermatchning.
Kända begränsningar
• Att tänka tar tid.
Resonemang lägger till verklig latens jämfört med konkurrenter i flash-klassen. För snabb idégenerering, skapa utkastet någon annanstans och ta hit den slutliga layouten.
• 2K-gräns.
Nano Bananas 4K- och utskriftsarbetsflöden över 2K behöver uppskalning eller en annan modell. För de flesta skärmar, irrelevant; för storformat, avgörande.
• En aprilkrona på en augustimarknad.
+242-marginalen mättes innan Seedream 5.0 Pro och sommarvågen landade. Fortfarande elit — men betrakta 'största ledningen någonsin' som historia, inte som den aktuella ställningen.
• Ingen webbförankring.
Den resonerar utifrån kunskap, inte livesökning — en bild av en aktuell produkt eller av morgonens nyheter kan komma tillbaka som föråldrad. Nano Banana 2:s grounding täcker det området.
Tre prompter som visa vad det är till för
Kopiera till generatorn ovan, byt ut hakparenteserna, rendera.
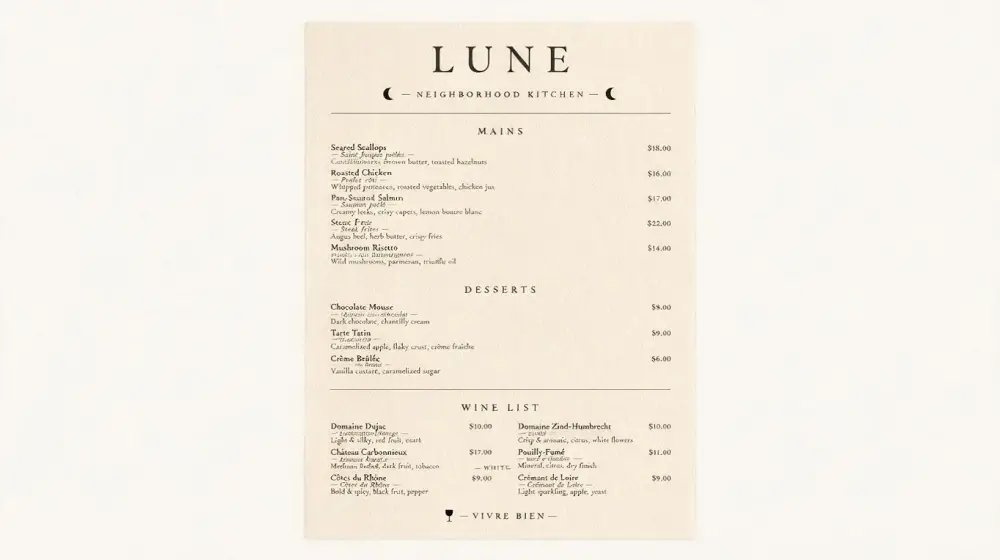
Menytestet — text under press
"En tryckfärdig bistromeny, A4 stående: '[LUNE — Kvarterskök]' som rubrik, fem huvudrätter med priser ($14–$22, högerställda), tre efterrätter, en kort vinlista, en fransk översättning under varje rätts namn. Varmt krämfärgat papper, klassisk serifsättning, inga stavfel."
Tät strukturerad text med formateringsregler är precis vad tänkeläget är till för — modellen skissar layouten innan den renderar en pixel. Demon bredvid generatorn är denna prompt.
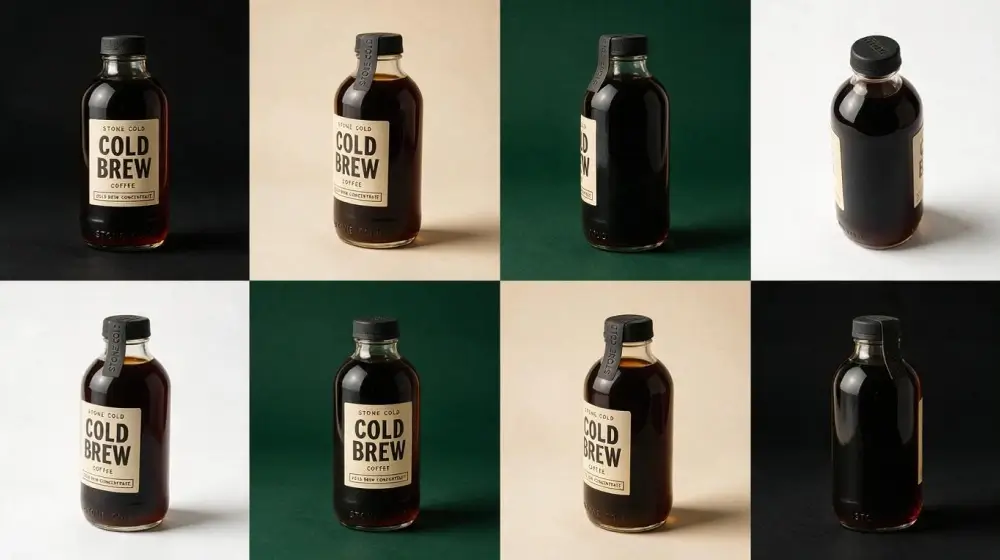
Omgången med åtta
Batch ×8 → "[Product] hero-bild, studiobelysning: åtta variationer som utforskar vinkel och bakgrundsfärg — samma produktskala, samma etikettorientering, samma skuggmjukhet i alla åtta."
Att ange vad som måste förbli identiskt gör en batch till ett kontrollerat experiment i stället för åtta lotterier. Välj vinnaren och rendera sedan om den ensam i full storlek.
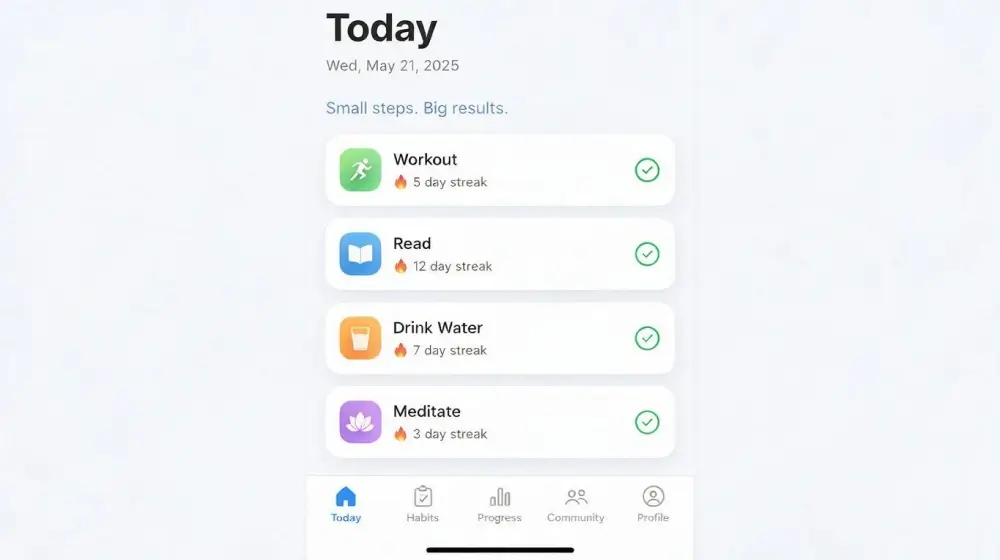
UI-skissen med texten
"En ren mobilappsskärm för [en vanespårare]: rubrik 'Idag', fyra vanekort med en ikon, namn och streakräknare på varje, ett nedre flikfält med fem märkta ikoner — alla etiketter läsbara och korrekt stavade, avstånd i iOS-stil, ljust läge."
Gränssnitt är texttäta dokument i förklädnad. Att räkna upp elementen aktiverar planeraren; 'läsbart och korrekt stavat' sätter ribban som textrenderaren faktiskt kommer att nå.
GPT Image 2 mot Nano Banana 2 mot Seedream 5.0 Pro
Tre flaggskepp, tre teorier: resonemang först, hastighet först, redigerbarhet först. Samma prompter i alla tre, bedömda efter vad vi skulle lansera. Alla tre kan väljas i generatorn ovan.
Hur det hamnade här
GPT Image 2.5
septemberförfiningen: upp till 50 % lägre latens, stabilare flertursredigeringar, Flare- och Sunburst-nivåer. Samma familj, samma planeringsbeteende. Hela sidan: gpt-image-2-5.
GPT Image 2
ChatGPT Images 2.0, lanserad 21 april: inbyggt tänkande, #1 i varje arenakategori med +242 inom tolv timmar, API som gpt-image-2. Versionen i generatorn ovan.
GPT Image 1.5
effektivitetsgenerationen: snabbare, billigare redigeringar som höll detaljerna intakta; den bästa offentliga OpenAI-bildmodellen fram till april.
Frågor om GPT Image 2, raka svar
OpenAI:s flaggskeppsmodell för bilder, lanserad den 21 april 2026 som ChatGPT Images 2.0 (API-namn gpt-image-2). Det är OpenAI:s första bildmodell med inbyggt resonemang — den planerar layout och kontrollerar innehåll före rendering — med tryckfärdig flerspråkig text, konsekventa batcher med 8 bilder och flexibla storlekar upp till 2K. Den debuterade som #1 i varje Image Arena-kategori med den största marginalen som någonsin registrerats.


